Python & Data Science · Inhouse-Schulung

Data Science mit Python: Inhouse-Schulung für Analyse-Teams

Ihr Team soll Daten nicht mehr nur in Tabellen schieben, sondern belastbar auswerten. Diese Schulung führt Analystinnen, Ingenieure und angehende Data Scientists in fünf Tagen von den Python-Grundlagen zu einem eigenständig gelösten Machine-Learning-Fall. Durchgehend hands-on am eigenen Rechner, mit Notebooks, die nach der Schulung im Team bleiben.

Über die Schulung

Vom Rohdatum bis zur bewerteten Vorhersage

Fünf Tage, ein durchgehender roter Faden: vom Rohdatum über Aufbereitung, Visualisierung und Statistik bis zur bewerteten Vorhersage. Jeder Tag endet mit lauffähigem Code, der letzte Tag mit einem Fall, den das Team selbst löst.

Die Schulung richtet sich an Analystinnen und Analysten, Ingenieurinnen und Ingenieure sowie Fachkräfte mit Programmiergrundverständnis, die in die Datenauswertung mit Python einsteigen. Vorwissen in Machine Learning ist nicht nötig, gemischte Vorkenntnisse sind der Normalfall: Das Tempo wird im Scoping auf die Gruppe abgestimmt. Arbeitet Ihr Team bereits produktiv mit Pandas und scikit-learn und sucht den Weg in den Betrieb, passt der MLOps-Workshop besser.

Schulungsziel

Was Ihr Team danach kann

  • Sauber mit dem Stack arbeiten. NumPy, Pandas, Matplotlib, scikit-learn in einer reproduzierbaren Umgebung, mit Skripten statt gewachsener Kopiervorlagen.
  • Daten aufbereiten, die nicht sauber sind. Einlesen, bereinigen, zusammenführen, fehlende Werte begründet behandeln. Das ist der Teil, der im Alltag die meiste Zeit frisst.
  • Ergebnisse zeigen, ohne zu täuschen. Aussagekräftige Grafiken, deskriptive Statistik und die typischen Fehlschlüsse, die in Berichten landen.
  • Modelle bewerten statt bewundern. Regression und Klassifikation mit scikit-learn, Validierung, passende Metriken, Überanpassung erkennen.
  • Die eigenen Grenzen einschätzen. Was das Team jetzt allein kann, wo der nächste Ausbauschritt liegt und wann ein Fall zu groß für Bordmittel ist.
Inhalt

Die fünf Tage

  • Tag 1, Python für Datenarbeit. Sprachgrundlagen, Datenstrukturen, Projektstruktur, Umgebung.
  • Tag 2, Pandas. Einlesen, Bereinigen, Transformieren, Verbinden echter Datensätze.
  • Tag 3, Visualisierung und Statistik. Grafiken, die eine Aussage tragen, deskriptive Statistik, Fehlschlüsse.
  • Tag 4, Machine Learning mit scikit-learn. Regression, Klassifikation, Validierungsstrategien, Metriken, Überanpassung.
  • Tag 5, Abschlussfall und Transfer. Eigenständige Bearbeitung eines vollständigen Durchstichs von Rohdaten bis Modellbewertung, gemeinsame Review, nächste Schritte im Team.
Formate & Termine

Drei Zuschnitte

Kompaktvariante, 2 bis 3 Tage
Umfang & Format2 bis 3 Tage, reduzierter Machine-Learning-Teil
ZielgruppeTeams mit Python-Vorkenntnissen oder engem Zeitfenster
Preisauf Anfrage
Nächste Terminenach Absprache
Das nehmen Sie mitPandas- und Visualisierungssicherheit, Einstieg in Modellbildung, Notebooks
Begleitung nach der Schulung
Umfang & Formatfortlaufend, tageweise
ZielgruppeTeams, die den ersten eigenen Fall umsetzen
Preisauf Anfrage
Nächste Terminenach Absprache
Das nehmen Sie mitCode-Review, Methodenberatung, Klärung offener Fragen am eigenen Projekt

Alle Formate: Deutsch & Englisch, hands-on am eigenen Rechner.

Alle Preise verstehen sich netto zzgl. gesetzlicher Umsatzsteuer. Das Angebot richtet sich ausschließlich an Unternehmer im Sinne des § 14 BGB.

Ihr Dozent und Berater

Unterrichtet, was er selbst einsetzt

Dr.-Ing. Grigory Devadze. Ich unterrichte Python und Data Science laufend für Firmenkunden und Bildungsanbieter im DACH-Raum, dazu Hochschullehre in KI und Machine Learning.

  • Aus der Projektpraxis. Dieselben Werkzeuge stehen in Beratungsprojekten im Einsatz, von Datenaufbereitung bis Modellbewertung.
  • Wissenschaftlich fundiert. Promotion in Elektrotechnik und Informationstechnik, Studium der Angewandten Mathematik, Publikationen in referierten Fachzeitschriften, u. a. im Journal of Automated Reasoning.
  • Kennt die Stolpersteine nach der Schulung. Der fünfte Tag ist genau deshalb ein eigenständig gelöster Fall und keine Vorführung.

Schulungen & Projekte u. a. für Siemens AG und SRH Hochschule Berlin.

→ Profil und Referenzen ansehen
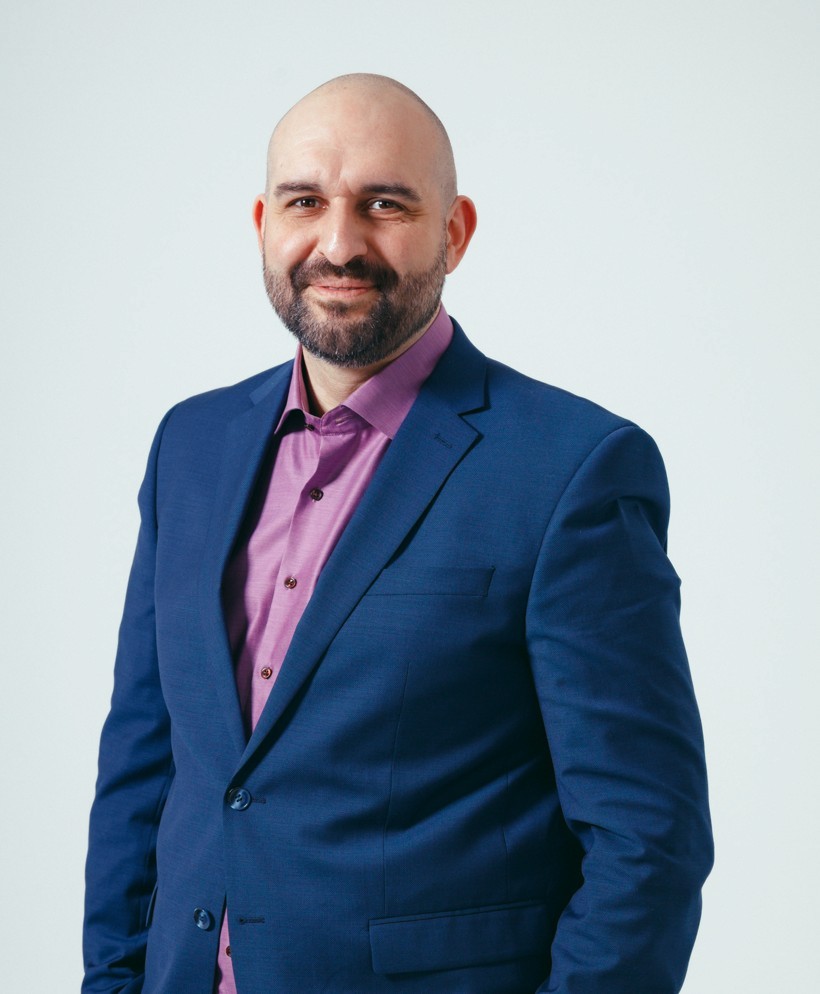
Dr.-Ing. Grigory Devadze
FAQ

Häufige Fragen

Wie viel Python muss das Team vorher können?

Grundverständnis von Programmierung reicht, eine andere Sprache ist eine gute Ausgangslage. Tag 1 fängt bei den Sprachgrundlagen an.

Können wir mit unseren eigenen Daten arbeiten?

Ja, für den Abschlussfall ist das der Regelfall und deutlich lehrreicher als ein Beispieldatensatz. Wenn eine Freigabe fehlt, arbeiten wir mit bereitgestellten Datensätzen.

Was ist mit Deep Learning?

Bewusst nicht Teil dieser Schulung. Fünf Tage reichen für einen soliden Stand in klassischer Datenanalyse und Modellbildung. Deep Learning ohne diese Grundlage erzeugt Ergebnisse, die niemand prüfen kann.

Bleiben die Notebooks bei uns?

Ja. Sie sind als Nachschlagewerk gedacht und bleiben nach der Schulung im Team.

Wie groß darf die Gruppe sein?

Hands-on funktioniert bis etwa zwölf Personen gut. Darüber leidet die individuelle Betreuung am Rechner, dann ist eine zweite Durchführung sinnvoller.

Anfrage

Das Team soll eigenständig auswerten können?

Kostenloses Vorgespräch zu Gruppenstand, Zielbild und Terminrahmen, danach Agenda und Angebot.
oderE-Mail schreiben